
 Bunlings: apps de sprint para o Jira





“Quando estes 22 ficam prontos?”
Todo time Kanban recebe essa pergunta. Ela costuma chegar numa quinta-feira, de alguém que precisa da resposta até sexta, e cai num quadro que nunca usou um story point na vida.
Boa notícia: você não precisa de nenhum. Algumas semanas passadas e um filtro do Jira bastam para uma resposta que você pode dizer em voz alta sem cruzar os dedos.
Como fazer previsão num quadro Kanban sem story points?
Conte quantos itens de trabalho chegaram a Concluído (Done) em cada uma das últimas quatro a seis semanas. Depois imagine que as próximas semanas vão se parecer com essas, sorteadas ao acaso, e veja quanto tempo os itens de trabalho restantes levariam. Repita algumas vezes e responda com a dispersão.
Essa dispersão é a previsão. Ela usa o que o seu time realmente concluiu, não o que alguém esperava que concluísse. Um item de trabalho que alguém um dia chamou de “um 3” e outro que chamou de “um 13” contam, os dois, como um item de trabalho concluído. Ao longo de várias semanas, os grandes e os pequenos tendem a se equilibrar, então a contagem é uma medida honesta do ritmo.
Throughput é a mesma coisa que velocity?
Não. Throughput (vazão) conta itens de trabalho concluídos. Velocity conta story points concluídos. Um só precisa de uma contagem; o outro precisa de uma estimativa em cada item de trabalho antes de a contagem começar.
| Throughput | Velocity | |
|---|---|---|
| O que você conta | Itens de trabalho concluídos | Story points concluídos |
| Precisa de estimativas antes | Não | Sim |
| Período | Qualquer um: um dia, uma semana, uma sprint | Uma sprint |
| Num quadro Kanban | Natural, sem sprints | Forçado |
| Parece | Traços de contagem num quadro branco | Contabilidade |
O lado do planejamento de sprint dessa comparação tem um artigo próprio: velocity ou throughput no planejamento da sprint. Este fica no lado do Kanban.
Como contar itens de trabalho concluídos no Jira?
Com um filtro. Abra Filtros (Filters), escolha Ver todos os itens de trabalho (View all work items), mude para JQL e cole isto, com a chave do seu próprio espaço:
project = ABC AND statusCategory = Done AND resolved >= -7dO Jira Cloud muda os menus de lugar de vez em quando, então os nomes podem variar um pouco.
O número de resultados é o throughput da semana passada. Para a semana anterior, use resolved >= -14d AND resolved < -7d, e assim por diante. Anote as contagens num post-it. Quatro a seis delas já é bastante.
Três coisas para conferir antes de confiar nos números:
- “Item de trabalho” é o novo “issue”. Documentos mais antigos e muitos tópicos de fórum ainda dizem issue. É a mesma coisa, com nome novo.
- “Resolved” depende do seu fluxo de trabalho. Se mover para Concluído não define uma resolução, o filtro volta vazio. Abra um item de trabalho concluído e confira. Se ele não tem resolução, conte as mudanças de status:
project = ABC AND status CHANGED TO Done DURING (-7d, now()), com o nome do seu próprio status Done. A documentação de busca avançada da Atlassian lista os outros campos. - Semanas calmas são semanas reais. Feriados, dias de doença e aquela semana em que todo mundo brigou com um único bug contam todos. Se você os tirar, sua previsão fica otimista, e suas sextas-feiras ficam constrangedoras.
Os quadros Kanban do Jira também trazem relatórios como o gráfico de controle (control chart) e o diagrama de fluxo cumulativo (cumulative flow diagram), conforme o tipo de espaço. Eles mostram quanto tempo os itens de trabalho levaram e onde se acumulam. Ótimos para achar um gargalo. Mas não entregam uma data de término.
Como é um exemplo na prática?
Digamos que suas últimas quatro semanas concluíram 4, 6, 3 e 5 itens de trabalho. (Números inventados, só para a conta.) São 18 em quatro semanas, ou 4,5 por semana.
Faltam 22 itens de trabalho. A resposta tentadora é 22 dividido por 4,5, cerca de 4,9, ou seja, “cinco semanas”. Isso é um número fantasiado de certeza.
O jeito rápido de ver a dispersão é testar sua semana mais lenta, a média e a mais rápida:
| Se as próximas semanas forem como… | Itens de trabalho por semana | Semanas para 22 |
|---|---|---|
| sua semana mais lenta | 3 | 7 a 8 |
| sua semana média | 4,5 | cerca de 5 |
| sua semana mais rápida | 6 | cerca de 4 |
Então a resposta honesta é “provavelmente cinco semanas, entre quatro e oito”. Dá para planejar em cima disso. E quando chegar a semana sete, ninguém se sente enganado.
Como funciona repetir as semanas passadas?
Escreva a contagem de cada semana num papelzinho e ponha os papéis num copo. Tire um para a primeira semana que vem, devolva, tire de novo para a segunda semana, e continue até as contagens sorteadas somarem 22. Anote quantas semanas isso levou. Faça algumas vezes e você tem um intervalo.
É o que chamam de previsão Monte Carlo. O nome é mais sofisticado do que a matemática.
À mão, dez ou vinte repetições bastam para ver o formato. A maioria cai no meio, algumas demoram mais, e essas poucas são justamente as que uma data única esconderia.
Por que dar um intervalo em vez de uma data?
Porque a resposta real já tem uma dispersão, e uma data única a esconde. Uma data convida a “mas vocês prometeram dia 25”. Um intervalo convida a “o que pode mudar isso?”, que é uma conversa muito melhor para ter numa quinta-feira.
Um intervalo também mostra onde está o problema. Se ele for largo, suas contagens semanais são irregulares, e a pergunta útil passa a ser por quê.
Duas coisas que uma previsão por throughput não sabe:
- Trabalho maior pela frente. Ela não sabe que os próximos 22 itens de trabalho são mais pesados do que os últimos 22.
- Gente ausente. Ela não sabe que duas pessoas estarão fora no mês que vem. Semanas passadas só descrevem semanas passadas.
E os itens de trabalho muito maiores que os outros?
São o único ponto fraco real de contar. Vinte itens de trabalho pequenos e vinte itens de trabalho pequenos mais um monstro não são a mesma previsão.
A solução é barata e antiga. Antes de prever, passe pelos itens de trabalho restantes e pergunte de cada um: “Isso tem mais ou menos o tamanho do que costumamos concluir?” Se sim, conta como um. Se não, divida até ficar assim. Você não está estimando em números, só separando em cabe e grande demais. Uma passada rápida pela lista resolve.
Como o Bunlings faz isso dentro do Jira?
Se você só quer as datas de épicos e releases, sem a sala de estimativa, o Bunlings Sprint Forecast (em inglês) dá uma data provável de término a partir das suas últimas semanas de trabalho concluído, e When will this epic or release be done? (em inglês) mostra o passo a passo.
O Bunlings é um app do Jira Cloud para estimativa e retrospectivas. A sala Kanban faz as duas etapas deste artigo: separar em cabe e grande demais, e depois prever.
O time vota em cada item de trabalho: Cabe ou Grande demais: dividir. Cabe significa que não deve levar mais do que este quadro costuma precisar; neste quadro de exemplo, até 7 dias úteis. As cartas ficam ocultas até a revelação e depois viram juntas, para a voz mais alta da sala não decidir o que conta como grande demais.
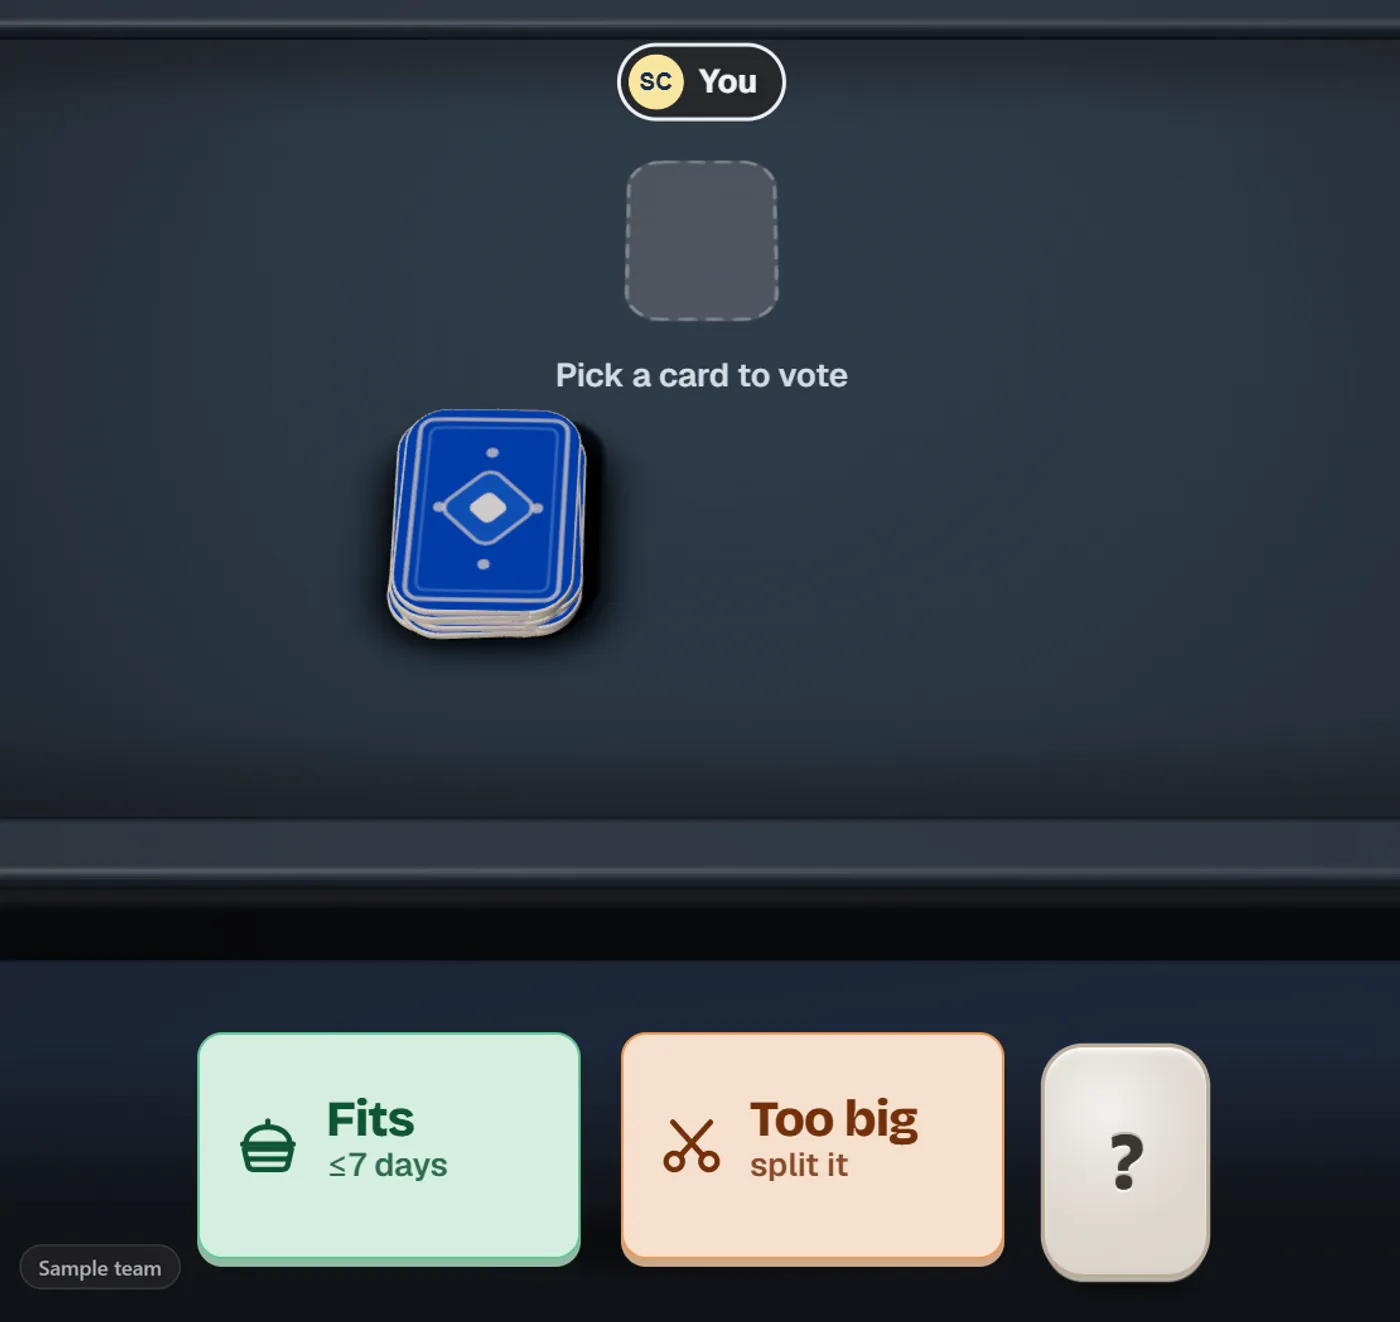
Todo mundo escolhe Cabe ou Grande demais, e as cartas viram juntas. A captura está em inglês. Time de exemplo, dados de exemplo.
Depois a sala lê o trabalho concluído recentemente no próprio quadro e faz por você a repetição do copo de papelzinhos. No exemplo abaixo, ela repetiu as semanas recentes muitas vezes e pôs 100 dessas tentativas num calendário, um ponto por tentativa.
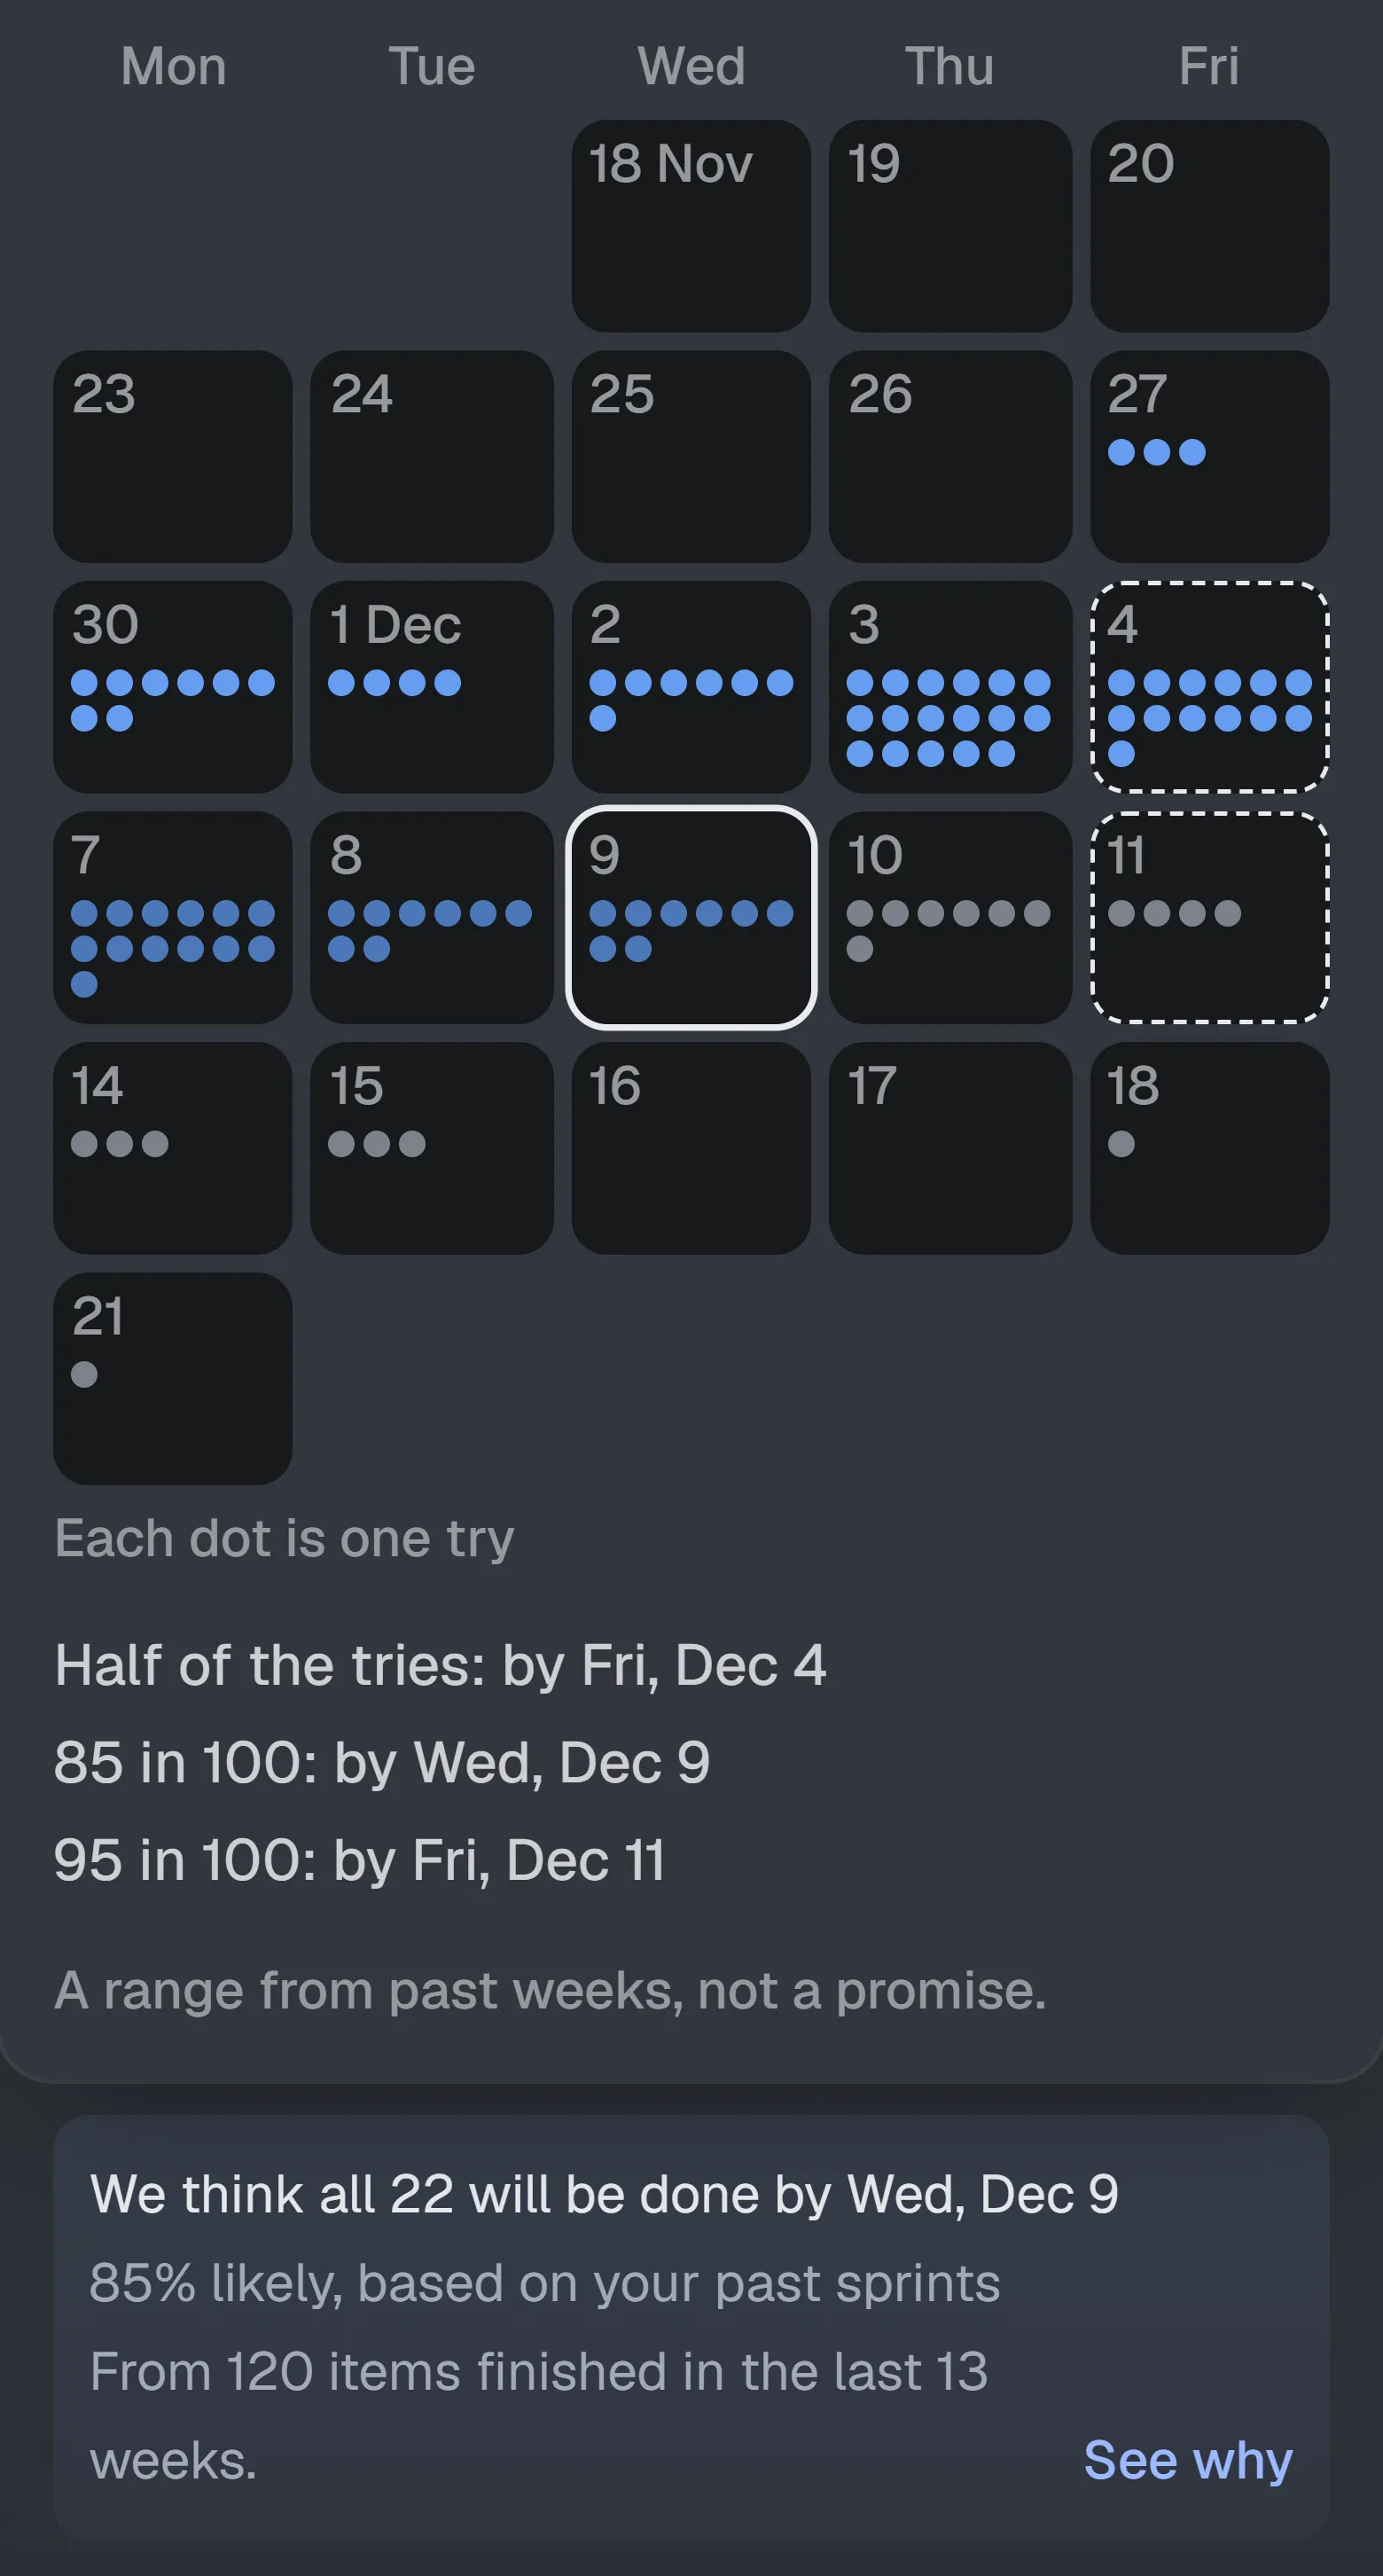
A maioria das tentativas cai no meio, algumas demoram mais. Essa cauda é o que uma data única esconde. Dados de exemplo. A captura está em inglês.
Alguns detalhes que vale saber:
- Ele dá uma data provável de término, nunca uma promessa. A sala diz isso na tela.
- Um voto Cabe fica na sala. Nada é gravado no Jira.
- Sem servidores externos, sem login novo, grátis para até 10 usuários. Só no Jira Cloud.
Se o seu quadro é pequeno e ninguém quer mais uma ferramenta, o filtro e o copo de papelzinhos bastam, francamente. O app é para times que preferem votar juntos a contar sozinhos.
Um checklist curto para a sua próxima previsão
- Escolha a janela: as últimas quatro a seis semanas.
- Conte os itens de trabalho concluídos por semana com um filtro. Anote as contagens.
- Separe os itens de trabalho restantes em cabe e grande demais. Divida os grandes demais.
- Repita as semanas, ou pelo menos teste o caso mais lento, o médio e o mais rápido.
- Diga um intervalo em voz alta, e o que poderia mudá-lo.
- Refaça na semana que vem, com mais uma semana de dados.
Experimente no seu próprio quadro
Conheça o Bunlings: planning poker e retros dentro do Jira
Instale o Bunlings no Atlassian Marketplace
Prefere assistir primeiro? Assista à demonstração (em inglês)