
 Bunlings : apps de sprint pour Jira





« Quand ces 22 seront-ils terminés ? »
Toute équipe Kanban reçoit cette question. Elle arrive plutôt un jeudi, de la part de quelqu’un qui a besoin de la réponse pour le vendredi, et elle atterrit sur un tableau qui n’a jamais utilisé un seul story point de sa vie.
Bonne nouvelle : vous n’en avez pas besoin. Quelques semaines passées et un filtre Jira suffisent pour une réponse que vous pouvez dire à voix haute sans croiser les doigts.
Comment prévoir sur un tableau Kanban sans story points ?
Comptez combien d’éléments de travail sont passés à Terminé chacune des quatre à six dernières semaines. Faites ensuite comme si les semaines à venir ressemblaient à celles-là, tirées au hasard, et voyez combien de temps il faudrait pour finir les éléments restants. Recommencez plusieurs fois et répondez par la dispersion.
Cette dispersion, c’est la prévision. Elle repose sur ce que votre équipe a réellement terminé, pas sur ce que quelqu’un espérait. Un élément de travail que quelqu’un a un jour appelé « un 3 » et un autre appelé « un 13 » comptent chacun pour un élément de travail terminé. Sur plusieurs semaines, les gros et les petits ont tendance à s’équilibrer : le comptage est donc une mesure honnête du rythme.
Le débit est-il la même chose que la vélocité ?
Non. Le débit (throughput) compte les éléments de travail terminés. La vélocité compte les story points terminés. L’un demande un décompte ; l’autre demande une estimation sur chaque élément de travail avant même que le décompte puisse commencer.
| Débit | Vélocité | |
|---|---|---|
| Ce que vous comptez | Des éléments de travail terminés | Des story points terminés |
| Estimations nécessaires d’abord | Non | Oui |
| Période | Quelconque : un jour, une semaine, un sprint | Un sprint |
| Sur un tableau Kanban | Naturel, pas besoin de sprints | Pénible |
| Cela ressemble à | Des traits sur un tableau blanc | De la comptabilité |
Le volet planification de sprint de cette comparaison a son propre article : vélocité ou débit pour planifier un sprint. Celui-ci reste du côté Kanban.
Comment compter les éléments de travail terminés dans Jira ?
Avec un filtre. Ouvrez Filtres, choisissez Afficher tous les éléments de travail (View all work items), passez en JQL et collez ceci, avec la clé de votre propre espace :
project = ABC AND statusCategory = Done AND resolved >= -7dJira Cloud déplace les menus de temps en temps : les noms peuvent donc changer un peu.
Le nombre de résultats est le débit de la semaine dernière. Pour la semaine d’avant, utilisez resolved >= -14d AND resolved < -7d, et ainsi de suite en remontant. Notez les nombres sur un post-it. Quatre à six suffisent largement.
Trois choses à vérifier avant de faire confiance aux nombres :
- « Élément de travail » est le nouveau nom des « tickets ». Les anciennes documentations et beaucoup de fils de forum parlent encore de « tickets » ou d’« issues ». C’est la même chose, sous un nouveau nom.
- « Resolved » dépend de votre workflow. Si le passage à Terminé ne définit pas de résolution, le filtre revient vide. Ouvrez un élément de travail terminé et vérifiez. S’il n’a pas de résolution, comptez plutôt les changements de statut :
project = ABC AND status CHANGED TO Done DURING (-7d, now()), avec le nom de votre propre statut « Done ». La documentation de la recherche avancée d’Atlassian (en anglais) liste les autres champs. - Les semaines calmes sont de vraies semaines. Les jours fériés, les jours de maladie et la semaine où tout le monde s’est battu contre un seul bug comptent tous. Retirez-les et votre prévision devient optimiste, et vos vendredis deviennent gênants.
Les tableaux Kanban de Jira proposent aussi des rapports comme le diagramme de contrôle (control chart) et le diagramme de flux cumulé (cumulative flow diagram), selon le type de votre espace. Ils montrent combien de temps les éléments de travail ont pris et où ils s’accumulent. Très bien pour repérer un goulot d’étranglement. Ils ne vous donnent pas de date de fin, en revanche.
À quoi ressemble un exemple chiffré ?
Supposons que vos quatre dernières semaines aient terminé 4, 6, 3 et 5 éléments de travail. (Des nombres inventés, juste pour le calcul.) Cela fait 18 en quatre semaines, soit 4,5 par semaine.
Il vous reste 22 éléments de travail. La réponse tentante est 22 divisé par 4,5, environ 4,9, donc « cinq semaines ». C’est un seul nombre déguisé en certitude.
Le moyen rapide de voir la dispersion est d’essayer votre semaine la plus lente, votre semaine moyenne et votre semaine la plus rapide :
| Si les semaines à venir ressemblent à… | Éléments de travail par semaine | Semaines pour 22 |
|---|---|---|
| votre semaine la plus lente | 3 | 7 à 8 |
| votre semaine moyenne | 4,5 | environ 5 |
| votre semaine la plus rapide | 6 | environ 4 |
La réponse honnête est donc « probablement cinq semaines, entre quatre et huit ». On peut planifier avec cela. Et quand la semaine sept arrive, personne ne se sent menti.
Comment fonctionne le rejeu des semaines passées ?
Écrivez chaque nombre hebdomadaire sur un bout de papier et mettez les papiers dans une tasse. Tirez un papier pour la première semaine à venir, remettez-le, tirez à nouveau pour la deuxième semaine, et continuez jusqu’à ce que les nombres tirés totalisent 22. Notez combien de semaines cela a pris. Faites-le plusieurs fois et vous avez une fourchette.
C’est ce qu’on appelle une prévision Monte-Carlo. Le nom est plus savant que les maths.
À la main, dix ou vingt rejeux suffisent pour voir la forme. La plupart tombent au milieu, quelques-uns s’allongent, et ces quelques-uns sont exactement ceux qu’une date unique aurait cachés.
Pourquoi donner une fourchette plutôt qu’une date ?
Parce que la vraie réponse a déjà une dispersion, et qu’une date unique la cache. Une date invite au « mais vous aviez promis le 25 ». Une fourchette invite au « qu’est-ce qui pourrait la faire bouger ? », ce qui est une bien meilleure conversation à avoir un jeudi.
Une fourchette montre aussi où se trouve le problème. Si elle est large, vos comptes hebdomadaires sont irréguliers, et la question utile devient : pourquoi.
Deux choses qu’une prévision de débit ne peut pas savoir :
- Un travail plus gros à venir. Elle ne sait pas que les 22 prochains éléments de travail sont plus massifs que les 22 derniers.
- Des personnes absentes. Elle ne sait pas que deux personnes seront absentes le mois prochain. Les semaines passées ne décrivent que les semaines passées.
Et les éléments de travail beaucoup plus gros que les autres ?
C’est la seule vraie faiblesse du comptage. Vingt petits éléments de travail et vingt petits plus un monstre ne donnent pas la même prévision.
Le remède est peu coûteux et ancien. Avant de prévoir, passez en revue les éléments de travail restants et demandez pour chacun : « Est-ce à peu près la taille de ce que nous terminons d’habitude ? » Si oui, il compte pour un. Sinon, découpez-le jusqu’à ce que ce soit le cas. Vous n’estimez pas en nombres, vous triez seulement entre ça tient et trop gros. Un passage rapide sur la liste suffit.
Comment Bunlings fait-il cela dans Jira ?
Si vous voulez seulement les dates pour les epics et les versions, sans la salle d’estimation, Bunlings Sprint Forecast (en anglais) donne une date de fin probable à partir de vos dernières semaines de travail terminé, et When will this epic or release be done? (en anglais) vous guide pas à pas.
Bunlings est une application Jira Cloud pour l’estimation et les rétrospectives. Sa salle Kanban fait les deux étapes de cet article : trier entre « ça tient » et « trop gros », puis prévoir.
L’équipe vote sur chaque élément de travail : Ça tient ou Trop gros : découper. « Ça tient » veut dire que cela ne devrait pas prendre plus longtemps que ce dont ce tableau a d’habitude besoin ; sur ce tableau d’exemple, jusqu’à 7 jours ouvrés. Les cartes restent masquées jusqu’à la révélation, puis se retournent ensemble : la voix la plus forte de la salle ne décide donc pas de ce qui est trop gros.
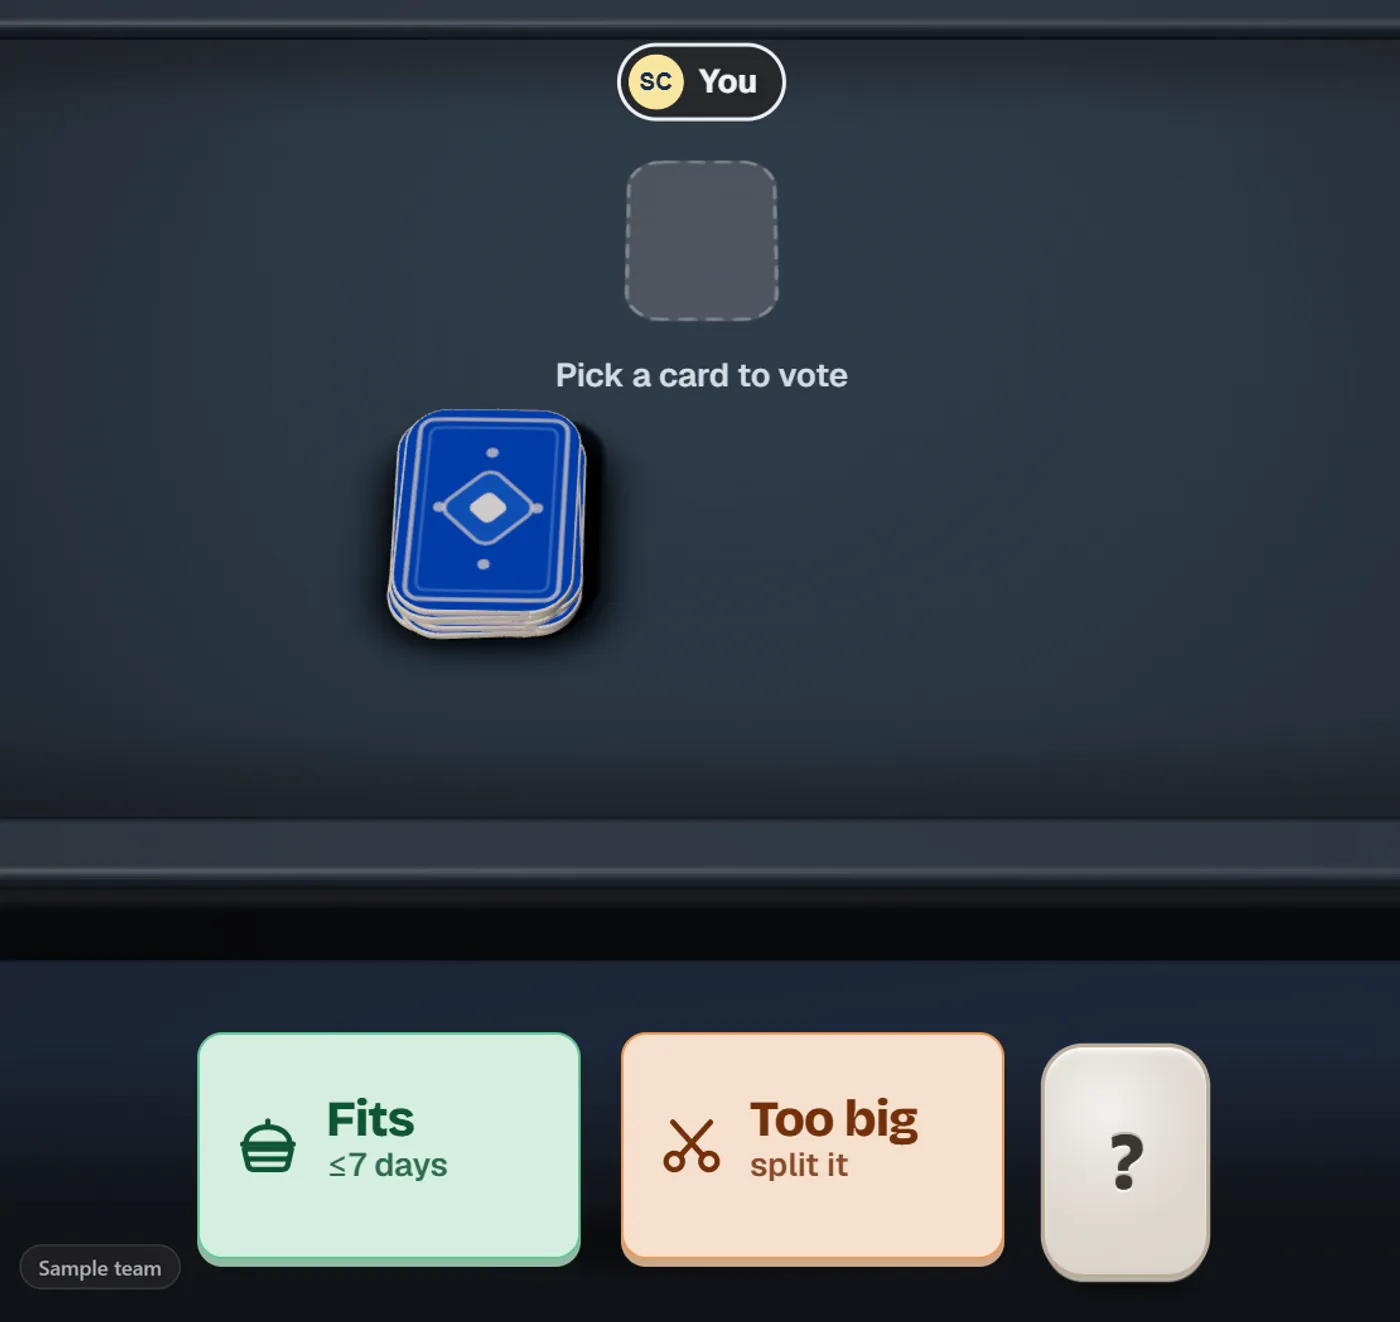
Chacun choisit « Ça tient » ou « Trop gros », et les cartes se retournent ensemble. La capture est en anglais. Équipe d’exemple, données d’exemple.
Ensuite, la salle lit le travail terminé récemment sur le tableau et fait pour vous le rejeu de la tasse de papiers. Dans l’exemple ci-dessous, elle a rejoué plusieurs fois les dernières semaines et placé 100 de ces essais sur un calendrier, un point par essai.
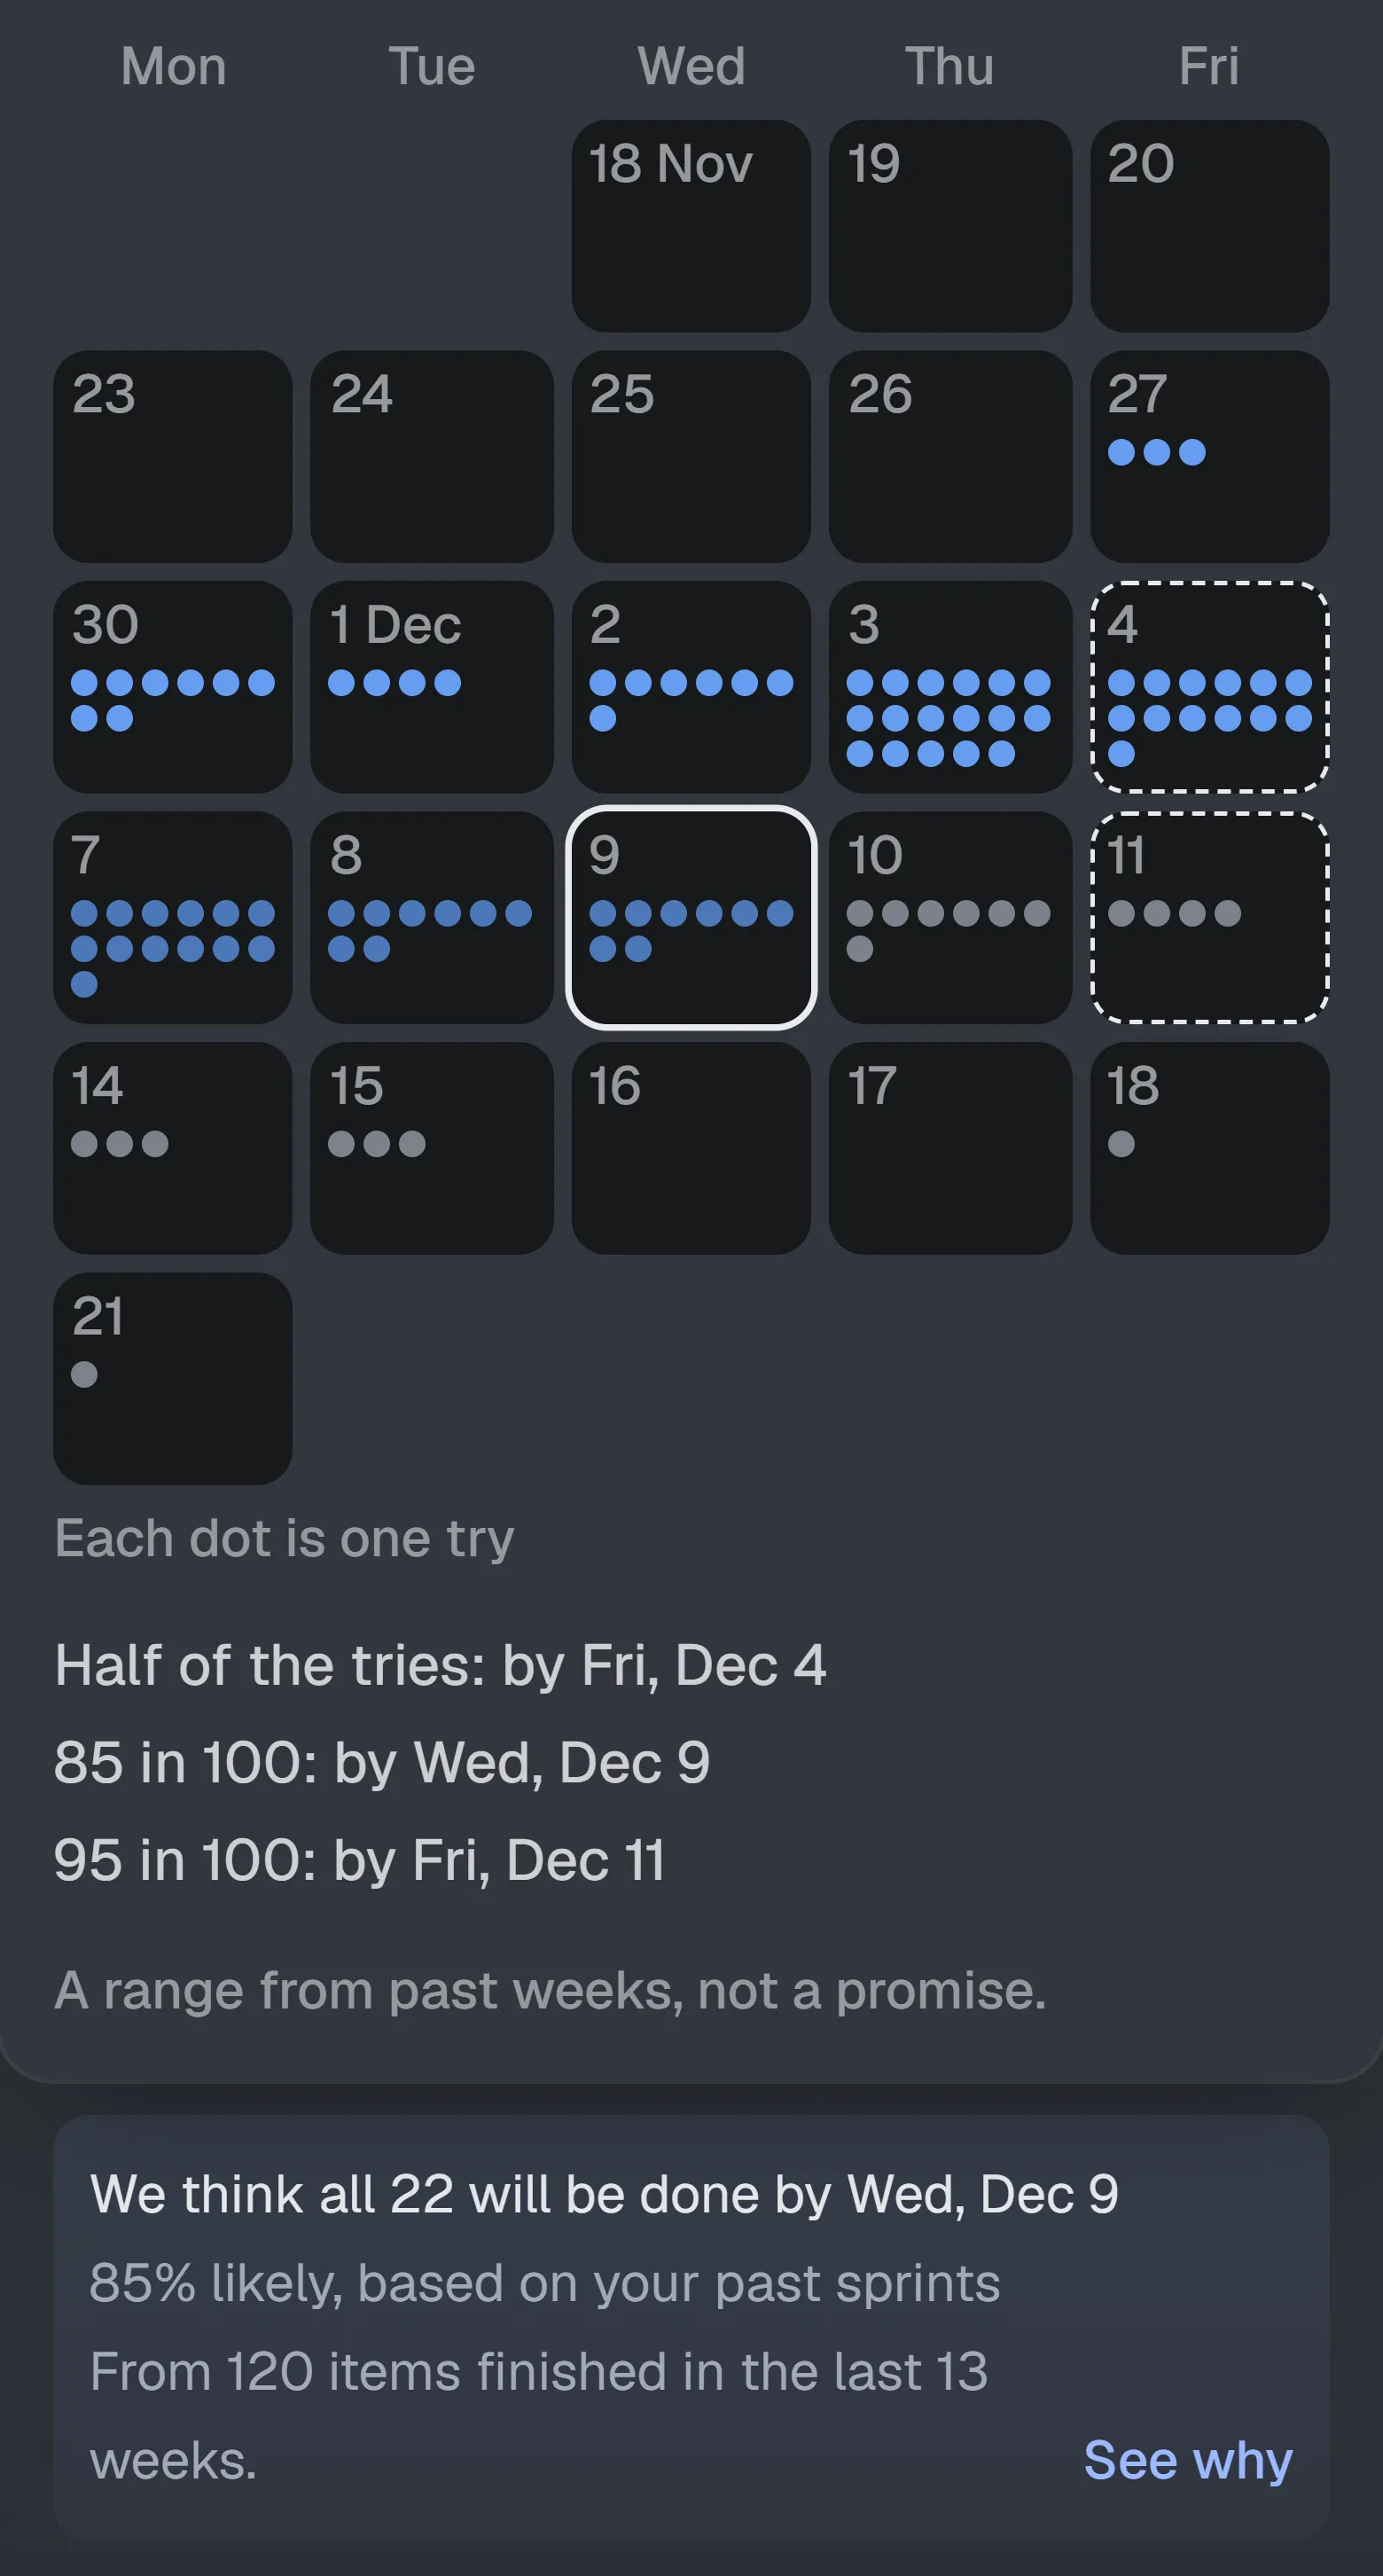
La plupart des essais tombent au milieu, quelques-uns s’allongent. Cette queue est ce qu’une date unique cache. La capture est en anglais. Données d’exemple.
Quelques détails à connaître :
- Elle donne une date de fin probable, jamais une promesse. La salle le dit à l’écran.
- Un vote « Ça tient » reste dans la salle. Rien n’est écrit dans Jira.
- Pas de serveurs externes, pas de nouvelle connexion, gratuit jusqu’à 10 utilisateurs. Jira Cloud uniquement.
Si votre tableau est petit et que personne ne veut d’un outil de plus, le filtre et la tasse de papiers suffisent honnêtement. L’application est pour les équipes qui préfèrent voter ensemble plutôt que compter seules.
Une courte liste de contrôle pour votre prochaine prévision
- Choisissez la fenêtre : les quatre à six dernières semaines.
- Comptez les éléments de travail terminés par semaine avec un filtre. Notez les nombres.
- Triez les éléments de travail restants entre « ça tient » et « trop gros ». Découpez les trop gros.
- Rejouez les semaines, ou essayez au moins le cas le plus lent, le cas moyen et le cas le plus rapide.
- Annoncez une fourchette à voix haute, avec ce qui pourrait la faire bouger.
- Recommencez la semaine prochaine avec une semaine de données de plus.
Essayez-le sur votre propre tableau
Voir Bunlings : planning poker et rétros directement dans Jira
Installer Bunlings depuis l’Atlassian Marketplace
Vous préférez regarder d’abord ? Voir la démo (en anglais)