
 Bunlings: apps de sprint para Jira





Planificación del sprint, 10:04. Alguien pregunta: «¿Cuánto podemos asumir?». La velocity dice 21 puntos. El throughput dice 7 elementos de trabajo. Las dos tienen razón, hasta que uno de esos elementos de trabajo resulta ser secretamente enorme.
Versión corta: la velocity suma tus estimaciones, el throughput cuenta elementos de trabajo terminados. Aquí tienes cuándo se gana cada una su sitio en la planificación del sprint, y cómo leer las dos en Jira sin una herramienta nueva.
¿Qué es la velocity?
La velocity es la estimación total que tu equipo termina en un sprint. Termina elementos de trabajo estimados en 5, 3, 8 y 5, y la velocity de ese sprint es 21.
El gráfico de velocidad de Jira la muestra por sprint: una barra para lo que el equipo se comprometió a hacer, otra para lo que terminó y una línea con la media de los sprints mostrados. El gráfico solo existe en espacios scrum, no en Kanban.
La velocity tiene un ingrediente principal: las estimaciones. Cuando un 5 significa más o menos lo mismo cada sprint, la velocity es una vara de medir útil. Cuando un 5 a veces son dos días y a veces dos semanas, el total lo esconde. Un 5 que tardó dos semanas sigue contando como 5. La velocity es muy indulgente en eso.
¿Qué es el throughput?
El throughput es cuántos elementos de trabajo termina tu equipo en un periodo fijo: una semana, un sprint, un mes. Sin estimaciones, sin tamaños, solo un recuento.
Digamos que un equipo inventado terminó 6, 9 y 7 elementos de trabajo en sus últimas tres semanas. Su throughput es de 6 a 9 por semana, unos 7 de media. Ese es todo el cálculo. Nadie discutió si algo era un 3 o un 5.
Parece demasiado simple para ser útil. Se sostiene cuando tus elementos de trabajo tienen más o menos el mismo tamaño, y se cae cuando no.
Velocity frente a throughput: ¿cuál es la diferencia?
La velocity mide trabajo estimado terminado. El throughput mide elementos de trabajo terminados. Todo lo demás se sigue de ahí.
| Velocity | Throughput | |
|---|---|---|
| Qué cuenta | Estimación total terminada | Elementos de trabajo terminados |
| Necesita estimaciones | Sí | No |
| Unidad típica | Story Points por sprint | Elementos de trabajo por semana o sprint |
| Sirve en Kanban | No en el gráfico de velocidad de Jira | Sí |
| Punto débil | Es tan honesta como las estimaciones | Trata igual un elemento de trabajo diminuto y uno enorme |
| Buena pregunta para ella | «¿Cuántos puntos caben en este sprint?» | «¿Cuántos elementos de trabajo para el día 24?» |
Ninguna de las dos es una nota del equipo. Las dos solo describen lo que ya pasó.
¿Cuándo debes usar la velocity?
Cuando tu equipo ya estima, trabaja en sprints y un 5 de este sprint significa más o menos lo mismo que un 5 del sprint pasado.
También da a la planificación del sprint una comprobación rápida de sensatez: «normalmente terminamos unos 21, y este plan dice 30».
El problema: la velocity hereda todos los hábitos de estimación de tu equipo. Si la primera voz de la sala fija el número para todos, tu velocity mide esa voz. Los votos ocultos ayudan, porque cada persona elige antes de oír a nadie más. Hay más sobre esto en planning poker en Jira.
¿Cuándo debes usar el throughput?
En tres situaciones.
- Tu equipo trabaja en Kanban. No hay sprints ni gráfico de velocidad, así que un recuento por semana es la medida natural.
- Tu equipo no estima. El throughput te da una previsión de todos modos.
- Tus elementos de trabajo tienen todos más o menos el mismo tamaño. Entonces estimarlos añade una reunión y poco más.
Es más débil cuando los tamaños varían mucho. Un elemento de trabajo enorme y nueve diminutos cuentan como diez. El throughput no entiende de matices. Si ese es tu tablero, divide los enormes o sigue estimando. Por qué fallan las estimaciones explica las razones habituales por las que los tamaños se desvían.
¿Cómo lees la velocity en Jira?
En el gráfico de velocidad, dentro de los informes del tablero. Tres pasos:
- Abre el tablero de un espacio scrum gestionado por la empresa (los espacios scrum gestionados por el equipo tienen su propio informe de velocidad).
- Ve a Informes (Reports) y elige Informe de velocidad (Velocity Chart).
- Compara las barras de lo terminado con las de lo comprometido, y mira la línea de la media.
El gráfico sigue el ajuste de estimación del tablero: Story Points, tiempo original, un campo numérico o el número de elementos de trabajo (work item count). Elige el número de elementos de trabajo y el mismo gráfico muestra el throughput por sprint. Ese ajuste cambia las estimaciones de todo el tablero, así que pregunta primero a quien administre tu tablero y vuelve a dejarlo como estaba después.
Lee las barras como un rango. Si tus últimos seis sprints terminaron entre 18 y 26, di «de 18 a 26», no «22».
¿Cómo lees el throughput en Jira?
Cuenta lo que terminaste. Esto sirve en cualquier tablero, scrum o Kanban. Pega esto en la búsqueda de elementos de trabajo (cámbiala a JQL):
project = ABC AND resolved >= startOfWeek(-4w) AND resolved < startOfWeek()Eso devuelve todo lo resuelto en las últimas cuatro semanas completas. (JQL sigue llamando project a un espacio.) Divide el recuento entre cuatro para sacar la media semanal, o mueve las fechas semana a semana para ver la dispersión.
¿El recuento sale demasiado bajo? Puede que tu flujo de trabajo no fije una resolución cuando los elementos de trabajo pasan a Hecho. Prueba esto:
project = ABC AND statusCategory = Done AND statusCategoryChangedDate >= startOfWeek(-4w) AND statusCategoryChangedDate < startOfWeek()En los tableros Kanban de espacios gestionados por la empresa, el gráfico de control (Control chart) muestra cuánto tardó cada elemento de trabajo, lo que te dice si las semanas pasadas son una guía razonable.
¿Puedes prever una fecha de fin con cualquiera de las dos?
Sí, como un rango. Divide el trabajo que queda entre tu ritmo reciente, una vez con una semana rápida y otra con una lenta.
- Velocity: el trabajo estimado que queda, dividido entre la velocity por sprint, da un número de sprints.
- Throughput: los elementos de trabajo que quedan, divididos entre los elementos de trabajo por semana, dan un número de semanas.
El equipo inventado de antes termina de 6 a 9 elementos de trabajo por semana y le quedan 36. 36 entre 9 es 4. 36 entre 6 es 6. Así que la respuesta es «de cuatro a seis semanas», y esa es una conversación mucho más fácil que defender una sola fecha.
Ninguno de los dos números sabe nada de una persona que se va, unas vacaciones largas o una sorpresa de producción. Lleva la ventana a la planificación del sprint, no una promesa. Si quieres esa ventana con probabilidades, Bunlings Sprint Forecast (en inglés) repite tus sprints pasados sobre el plan, y ¿Terminaremos el sprint? (en inglés) muestra cómo hacerlo a mano.
¿Cuál debería elegir tu equipo?
La que encaje con cómo ya trabaja tu equipo. Una prueba corta:
- ¿Trabajas en sprints y confías en tus tamaños? Usa la velocity.
- ¿Trabajas en Kanban, no estimas o tienes sobre todo trabajo de tamaño parecido? Usa el throughput.
- ¿No lo tienes claro? Registra las dos durante un mes: el gráfico de velocidad para los puntos, el recuento JQL de arriba para los elementos de trabajo. Sin una segunda herramienta y sin ajustes del tablero que cambiar.
Elijas la que elijas, deja fuera las semanas raras (unas vacaciones, un incendio en producción), di cuáles y da un rango.
¿Dónde encaja Bunlings?
Bunlings no tiene un gráfico de velocity ni de throughput, y no sustituye los informes de Jira. Es una app de Jira para planning poker (scrum poker) y retros, y ayuda con el punto débil de cada una.
Para la velocity, el punto débil son las estimaciones. En Bunlings, los votos se quedan ocultos hasta que las cartas se dan la vuelta a la vez, así que cada persona elige antes de ver el número de nadie más. «Acordar» guarda el resultado en el campo de estimación propio del tablero, como Story Points, con 10 segundos para deshacerlo. Y cada carta muestra cuánto tardó realmente esa estimación en tu equipo en este tablero, así que ves si un 5 significa dos días o dos semanas antes de que entre en tu velocity.
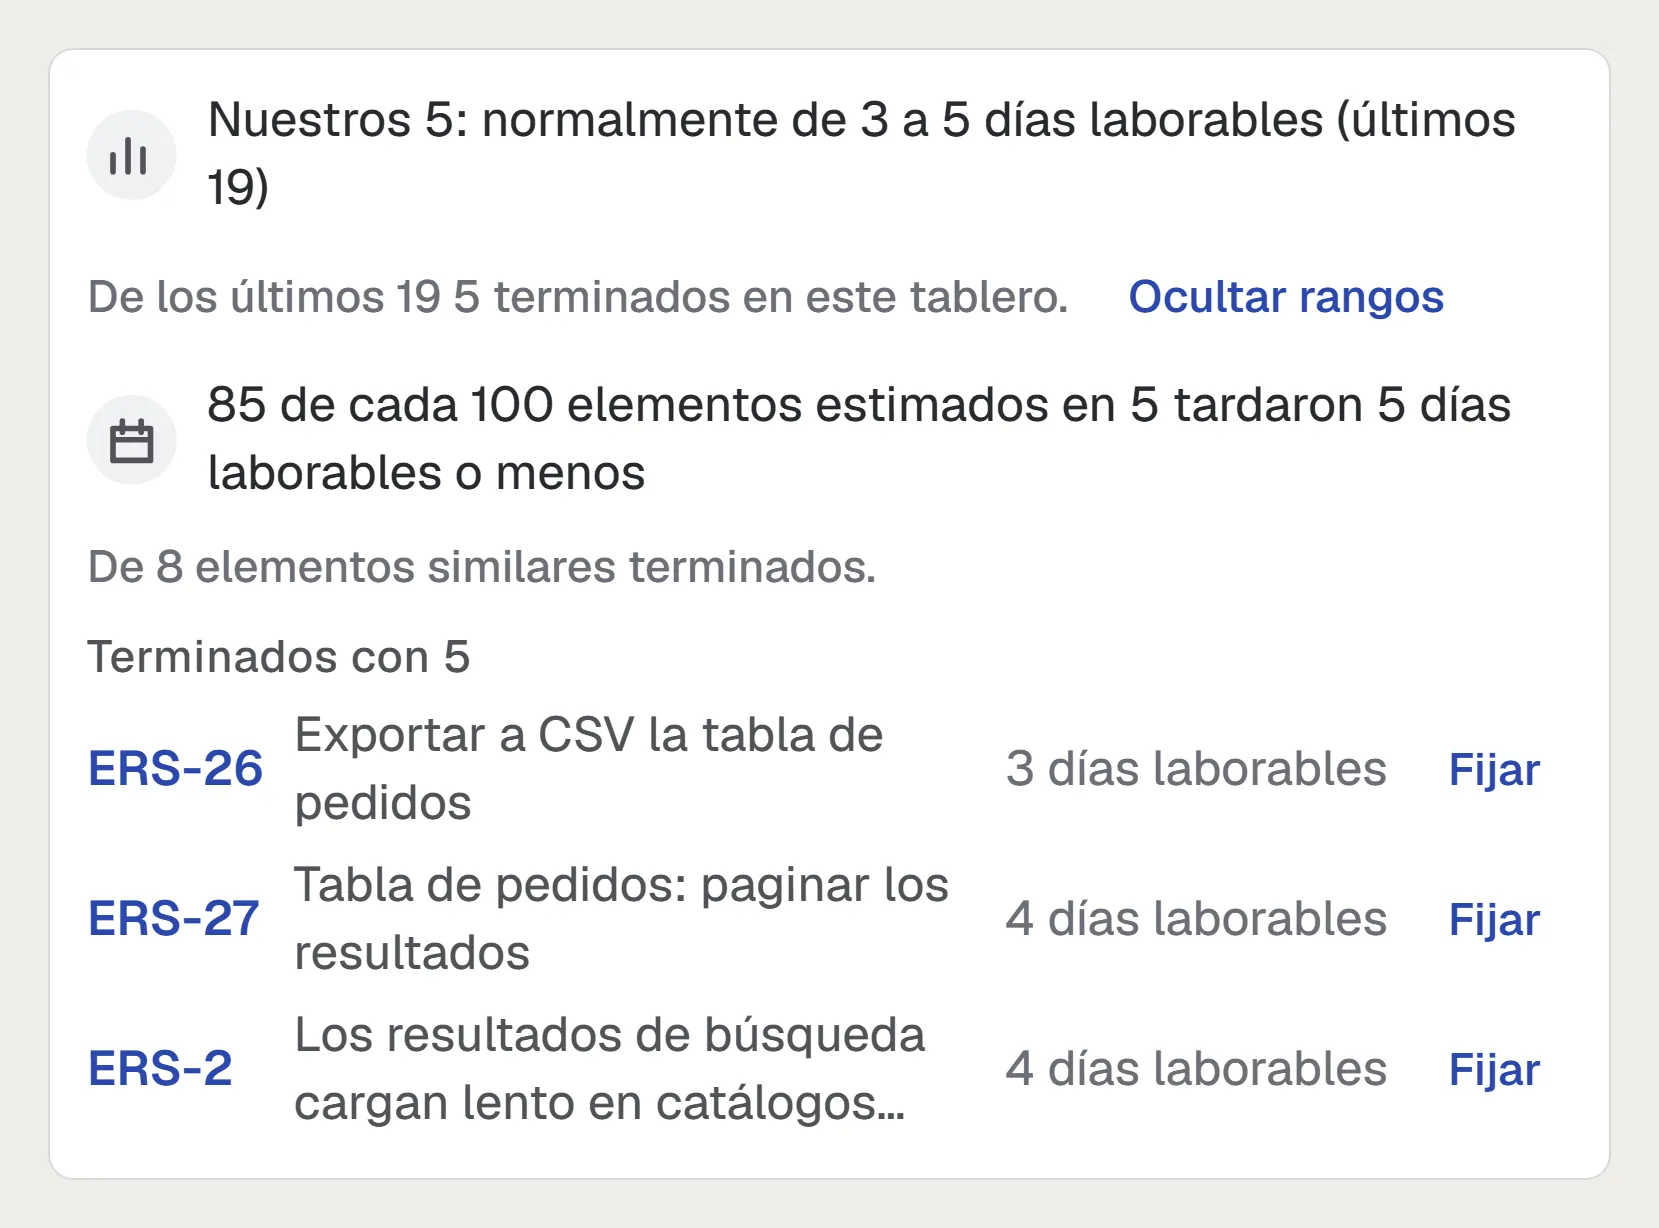
Equipo y datos de ejemplo. «Nuestros 5: normalmente de 3 a 5 días laborables (últimos 19)», calculado a partir de los 5 terminados que se listan debajo.
Para el throughput, el punto débil es el tamaño: un elemento de trabajo enorme sigue contando como uno. En un tablero Kanban, el equipo vota «Cabe» o «Muy grande» en cada elemento de trabajo, así que los gigantes se dividen antes de esconderse en el recuento. La sala muestra entonces una fecha de fin probable, calculada a partir de las últimas semanas del propio tablero. Un voto «Cabe» se queda en la sala y no escribe nada en Jira.
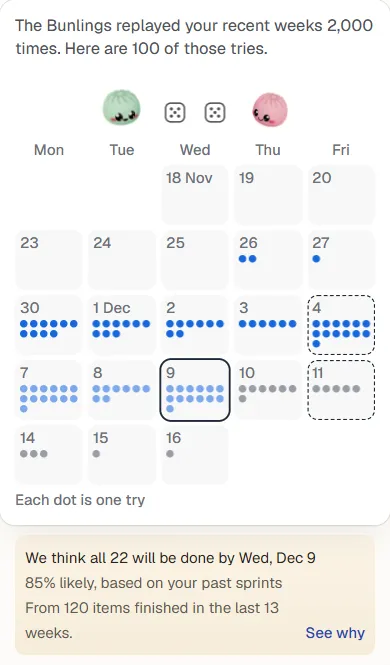
Equipo de ejemplo. «We think all 22 will be done by Wed, Dec 9»: cada punto es un intento simulado. La captura está en inglés. Una fecha probable es una previsión basada en el pasado, nunca una promesa.
Las estimaciones guardadas también se pueden buscar en Jira, así que «¿qué acordamos este mes?» está a una búsqueda de distancia. Para saber más sobre previsión sin estimaciones, lee previsión Kanban sin Story Points. Para ver la app entera junto a Jira sin más, mira Jira nativo frente a Bunlings.
Pruébalo
Bunlings es gratis hasta 10 usuarios y funciona dentro de Jira Cloud.